
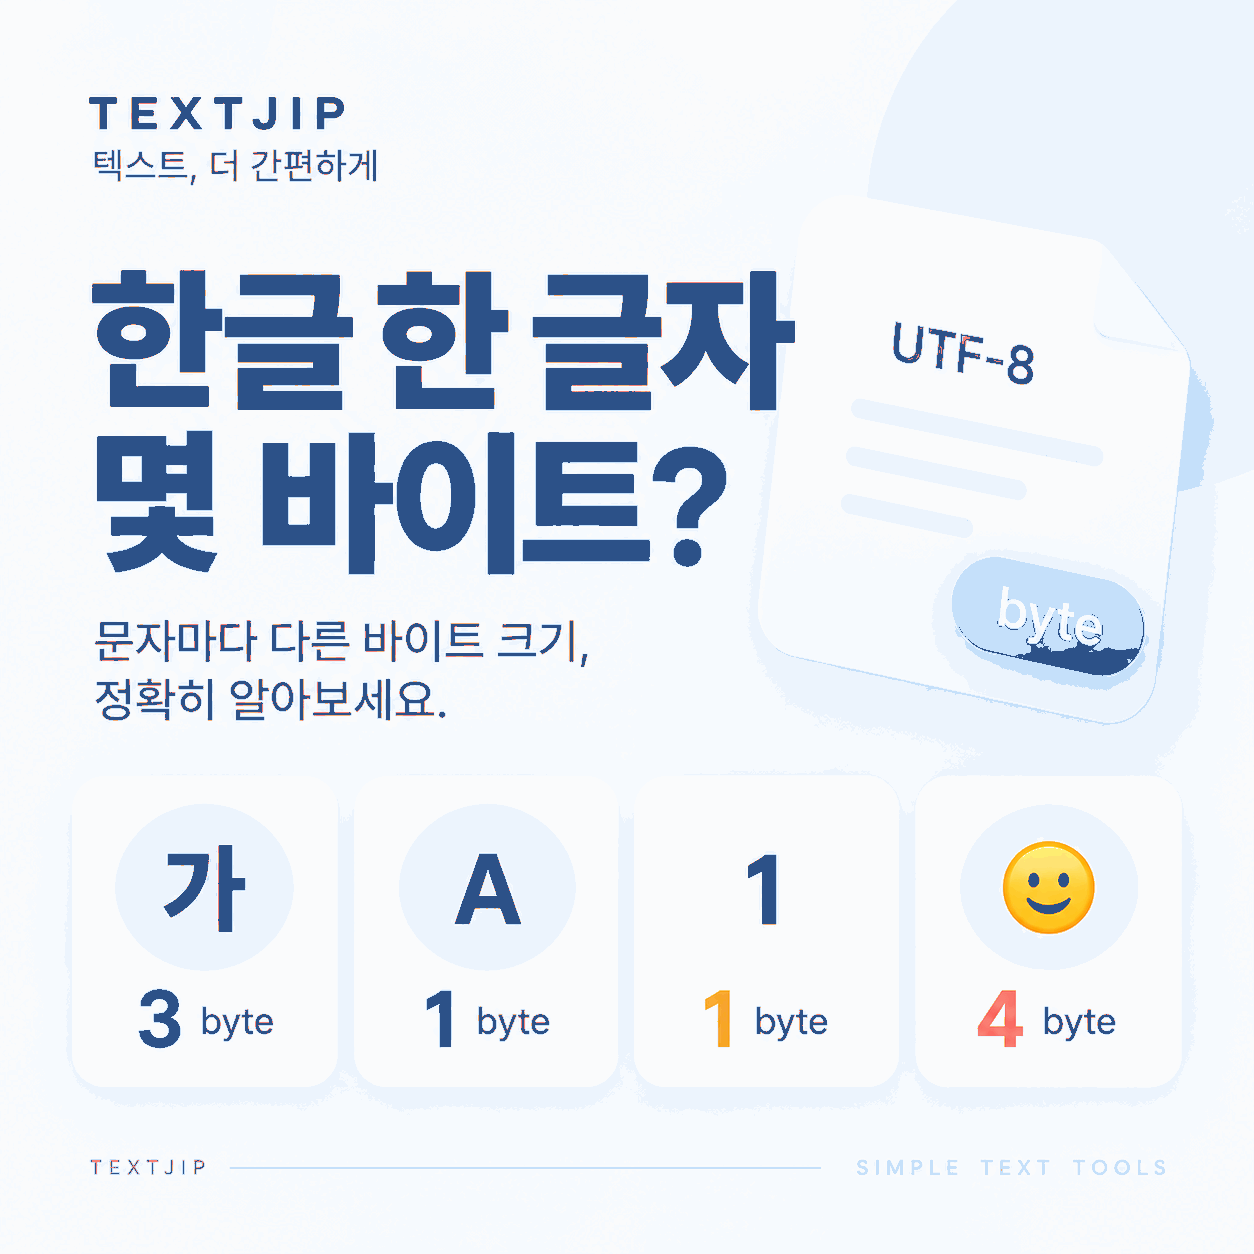
글자수와 바이트는 비슷해 보이지만 서로 다른 개념입니다. 화면에서는 한 글자로 보이는 문자도 컴퓨터가 저장하거나 전송할 때는 여러 바이트의 공간을 사용할 수 있습니다.
특히 UTF-8 환경에서는 일반적인 영문과 숫자보다 한글 한 글자가 더 많은 바이트를 사용하기 때문에 글자수 제한과 바이트 제한을 같은 뜻으로 생각하면 실제 입력 가능한 분량을 잘못 계산할 수 있습니다.
UTF-8 기준 한글 한 글자는 일반적으로 3바이트입니다
현재 웹사이트와 다양한 온라인 서비스에서 널리 사용되는 UTF-8 문자 인코딩을 기준으로 보면 일반적인 한글 완성형 한 글자는 보통 3바이트를 사용합니다.
따라서 한글 10자를 입력했다고 해서 10바이트가 되는 것은 아닙니다. 단순한 한글 10글자만 있다면 UTF-8에서는 일반적으로 30바이트 정도가 됩니다.
왜 한글과 영문은 사용하는 바이트가 다를까요?
컴퓨터는 문자를 그대로 저장하는 것이 아니라 각 문자를 특정한 숫자 체계로 변환해 처리합니다. 이때 어떤 문자 인코딩을 사용하느냐에 따라 필요한 바이트 수가 달라집니다.
UTF-8은 영어권에서 주로 사용하던 ASCII 문자와 호환되면서도 한글, 일본어, 중국어, 여러 특수문자와 이모지까지 표현할 수 있도록 설계된 가변 길이 인코딩입니다.
그래서 영문 알파벳처럼 기본 ASCII 범위에 속하는 문자는 보통 1바이트, 한글처럼 더 넓은 문자 범위에 속하는 문자는 여러 바이트를 사용합니다.
영문·숫자·한글 바이트를 비교하면
| 문자 예시 | 문자 종류 | UTF-8 기준 일반적인 크기 | 비고 |
|---|---|---|---|
| A | 영문 대문자 | 1바이트 | ASCII 범위 |
| a | 영문 소문자 | 1바이트 | ASCII 범위 |
| 1 | 숫자 | 1바이트 | ASCII 범위 |
| 가 | 한글 | 3바이트 | 일반적인 한글 완성형 기준 |
| 한 | 한글 | 3바이트 | 일반적인 한글 완성형 기준 |
| 일부 이모지 | 이모지 | 4바이트 이상 가능 | 조합형 이모지는 더 커질 수 있음 |
한글 100자는 300바이트일까요?
일반적인 한글 완성형 글자만 100개 들어 있고 UTF-8을 기준으로 계산한다면 대략 300바이트로 볼 수 있습니다.
하지만 실제 문장에는 띄어쓰기, 숫자, 영문, 특수문자, 줄바꿈 등이 함께 들어가기 때문에 전체 바이트는 단순히 글자수에 3을 곱한 값과 달라질 수 있습니다.
띄어쓰기 한 칸도 바이트를 사용합니다
글자수 계산에서는 공백 포함과 제외를 따로 볼 수 있지만, 실제 데이터 크기를 계산할 때는 띄어쓰기 역시 하나의 문자 데이터입니다.
UTF-8에서 일반적인 스페이스는 보통 1바이트를 사용합니다. 따라서 한글 문장을 바이트로 계산하면 한글 글자뿐 아니라 단어 사이의 공백도 전체 바이트에 영향을 줍니다.
실제 문장에는 한글 이외에도 공백, 숫자, 영문, 줄바꿈, 특수문자가 함께 들어가기 때문입니다. 전체 바이트가 중요하다면 문장 전체를 UTF-8 기준으로 직접 계산하는 것이 정확합니다.
한글 500자와 500바이트는 완전히 다릅니다
입력란에서 500자 제한과 500바이트 제한은 전혀 다른 의미입니다.
한글 500자는 말 그대로 한글을 비롯한 문자 개수를 기준으로 최대 500자를 허용한다는 의미에 가깝지만, 500바이트 제한이라면 각 문자가 차지하는 데이터 크기를 합산해 제한합니다.
UTF-8 기준으로 한글은 일반적으로 3바이트이므로 한글만 입력한다면 500바이트 안에 500글자를 넣을 수 없습니다.
일부 시스템은 UTF-8이 아닌 다른 문자 인코딩이나 자체 계산 방식을 사용할 수 있습니다. 따라서 중요한 입력 제한은 해당 사이트가 안내하는 기준을 우선해야 합니다.
한글 바이트 계산이 필요한 대표적인 상황
일부 시스템이나 오래된 입력창에서는 글자수가 아니라 바이트를 기준으로 최대 길이를 제한합니다.
개발 환경에서는 문자열을 저장할 때 문자 개수와 실제 데이터 크기를 구분해야 할 수 있습니다.
전송할 데이터의 크기를 계산하거나 특정 바이트 제한을 맞출 때 UTF-8 바이트 계산이 필요할 수 있습니다.
입력란 옆에 1,000바이트처럼 표시되어 있다면 실제 글자수와 다른 기준으로 제한될 수 있습니다.
특수문자는 모두 1바이트일까요?
아닙니다. 키보드에서 쉽게 입력할 수 있다고 해서 모든 특수문자가 1바이트인 것은 아닙니다.
영문 키보드에서 사용하는 기본적인 ASCII 범위의 일부 기호는 UTF-8에서 1바이트이지만, 다양한 통화 기호나 장식 문자, 다른 유니코드 영역의 기호는 더 많은 바이트를 사용할 수 있습니다.
따라서 특수문자가 많이 포함된 문장의 바이트를 문자 개수만으로 정확하게 추정하는 것은 어렵습니다.
이모지는 왜 바이트 계산이 더 복잡할까요?
일부 이모지는 하나의 유니코드 코드 포인트로 표현되지만, 다른 이모지는 여러 문자가 결합되어 화면상 하나의 그림처럼 보일 수 있습니다.
피부색 변형, 가족 형태, 성별 표현, 국기처럼 여러 요소가 결합된 이모지는 화면에서는 한 글자로 보여도 내부 데이터에서는 여러 코드 포인트가 사용될 수 있습니다.
단일 이모지는 UTF-8에서 4바이트인 경우가 많지만, 여러 코드 포인트가 결합된 이모지는 전체 데이터 크기가 그보다 더 클 수 있습니다.
한글 자모를 따로 입력하면 결과가 달라질 수 있습니다
화면상 한글은 보통 완성된 음절 형태로 입력되지만, 일부 환경에서는 초성·중성·종성이 분리된 유니코드 문자 조합으로 존재할 수 있습니다.
겉으로 비슷해 보이는 텍스트라도 내부 문자 구성이 다르면 문자 수나 바이트 계산 결과가 달라질 가능성이 있습니다.
일반적인 문서 작성에서는 크게 의식할 필요가 없지만, 프로그램이나 데이터 처리 과정에서 결과가 예상과 다를 때는 문자 정규화나 유니코드 구성을 확인해야 할 수도 있습니다.
글자수와 바이트를 한 번에 확인하는 방법
문장 안에 한글과 영문, 숫자, 공백이 섞여 있다면 직접 계산하는 것보다 전체 텍스트를 자동으로 계산하는 것이 간단합니다.
텍스트집 글자수 세기
텍스트를 입력하면 공백 포함·제외 글자수뿐 아니라 UTF-8 기준 전체 바이트도 실시간으로 확인할 수 있습니다. 한글과 영문이 섞인 문장도 전체 문자열을 기준으로 계산합니다.
UTF-8 바이트 확인하기바이트 제한이 있다면 이렇게 확인하세요
- 제한 단위가 글자인지 바이트인지 확인합니다.
- 사이트가 안내하는 문자 인코딩 또는 계산 기준이 있는지 확인합니다.
- 작성한 전체 문장의 UTF-8 바이트를 확인합니다.
- 한글뿐 아니라 공백·영문·숫자·특수문자도 함께 계산합니다.
- 최종 입력창에서 실제 제한 초과 여부를 다시 확인합니다.
한글 바이트 계산에서 흔히 하는 실수
- 한글 한 글자가 어떤 환경에서도 무조건 3바이트라고 생각하는 경우
- 글자수와 바이트를 같은 단위라고 생각하는 경우
- 문장 전체 바이트를 한글 글자수 × 3으로만 계산하는 경우
- 띄어쓰기와 줄바꿈은 바이트를 사용하지 않는다고 생각하는 경우
- 모든 이모지를 동일한 바이트 크기로 계산하는 경우
- 실제 입력 서비스의 자체 계산 기준을 확인하지 않는 경우
UTF-8이 아닌 환경에서는 한글 바이트가 달라질 수 있습니다
한글 한 글자가 일반적으로 3바이트라고 설명하는 것은 UTF-8을 기준으로 한 것입니다.
다른 문자 인코딩을 사용하는 시스템에서는 동일한 한글이라도 다른 바이트 수를 사용할 수 있습니다. 과거의 일부 한국어 시스템에서는 EUC-KR 같은 다른 인코딩을 사용하기도 했습니다.
따라서 특정 시스템의 바이트 제한을 맞춰야 한다면 단순히 UTF-8 계산 결과만 보는 것이 아니라 해당 서비스가 어떤 기준을 사용하는지 확인하는 것이 중요합니다.
자주 묻는 질문
한글 한 글자는 몇 바이트인가요?
UTF-8 기준 일반적인 한글 완성형 한 글자는 보통 3바이트입니다. 다만 다른 문자 인코딩을 사용하는 환경에서는 결과가 달라질 수 있습니다.
영문 한 글자는 몇 바이트인가요?
UTF-8에서 기본 영문 알파벳은 일반적으로 1바이트입니다.
숫자도 1바이트인가요?
일반적인 ASCII 숫자 0부터 9까지는 UTF-8에서 각각 1바이트입니다.
한글 100자는 몇 바이트인가요?
일반적인 한글 완성형 100글자만 있다면 UTF-8 기준 약 300바이트입니다. 공백, 영문, 숫자, 특수문자가 섞이면 전체 바이트는 달라집니다.
한글 500자는 1,500바이트인가요?
한글 완성형 500글자만 있다는 조건에서는 UTF-8 기준 약 1,500바이트로 볼 수 있습니다. 실제 문장에는 공백이나 다른 문자가 포함될 수 있으므로 전체 텍스트를 직접 계산하는 것이 정확합니다.
이모지는 몇 바이트인가요?
문자에 따라 다릅니다. 단일 이모지는 UTF-8에서 4바이트인 경우가 많지만, 여러 코드 포인트가 결합된 이모지는 전체 바이트가 더 커질 수 있습니다.
띄어쓰기 한 칸도 바이트에 포함되나요?
네. 일반적인 스페이스는 UTF-8에서 보통 1바이트를 사용합니다.
글자수 계산기와 실제 사이트의 바이트가 다를 수도 있나요?
가능합니다. 사이트가 UTF-8이 아닌 다른 문자 인코딩이나 자체 계산 방식을 사용하면 차이가 생길 수 있으므로 실제 서비스가 제공하는 안내를 우선 확인하세요.
함께 보면 좋은 텍스트집 콘텐츠
정리하면
UTF-8을 기준으로 일반적인 한글 완성형 한 글자는 보통 3바이트, 기본 영문 알파벳과 숫자는 일반적으로 1바이트를 사용합니다.
하지만 실제 문장에는 띄어쓰기, 영문, 숫자, 특수문자, 이모지가 함께 들어가기 때문에 전체 바이트를 정확히 알고 싶다면 문장 전체를 기준으로 계산해야 합니다.
특히 바이트 제한이 있는 입력창에서는 단순히 글자수에 숫자를 곱해 추정하지 말고 해당 서비스의 인코딩 기준과 실제 입력 결과를 함께 확인하는 것이 가장 안전합니다.